深度学习主机配置指南 10卡RTX 4090与H100 GPU服务器在大模型推理训练中的数据处理与存储支持
随着大模型时代的到来,深度学习主机的算力配置与数据支持服务成为影响模型训练与推理效率的关键因素。本文围绕10卡RTX 4090与H100 GPU服务器,探讨其在大模型推理训练中的适用场景,并深入分析数据处理与存储支持服务的重要性,为构建高效、稳定的深度学习计算平台提供参考。
一、GPU选型:RTX 4090与H100的定位差异
RTX 4090作为消费级旗舰显卡,拥有24GB GDDR6X显存和强大的FP16/FP32算力,单卡性价比极高。10卡RTX 4090主机可提供总计240GB显存,适合中等规模模型的并行训练与推理。其优势在于成本可控、生态成熟,尤其适合初创团队和科研院校。RTX 4090不支持NVLink高速互联,多卡通信依赖PCIe总线,在大规模分布式训练中可能成为瓶颈。
相比之下,H100是NVIDIA面向数据中心的旗舰计算卡,配备80GB HBM3显存,支持NVLink和NVSwitch,单卡AI算力远超RTX 4090。10卡H100服务器可提供800GB显存和极高的卡间带宽,适合千亿参数级大模型的训练与高并发推理。但H100成本高昂,需要配套的高功率电源与散热系统。选择哪种配置,需综合考虑模型规模、预算与长期扩展性。
二、大模型推理训练对主机的核心要求
无论是10卡4090还是H100服务器,跑通大模型推理训练不仅取决于GPU数量,更依赖整机系统的均衡设计:
- CPU与内存:推荐搭配高核心数服务器CPU(如AMD EPYC或Intel Xeon),内存容量至少为显存的2-4倍,确保数据预处理与多卡调度不成为瓶颈。
- 高速互联:多卡训练需关注PCIe通道分配,H100建议启用NVLink;10卡4090方案则需选用支持多PCIe x16插槽的主板,并考虑使用RDMA网络实现跨节点通信。
- 电源与散热:10卡4090满载功耗约4.5kW,H100服务器可达10kW以上,需配备冗余电源和工业级散热方案。
三、数据处理与存储支持服务的关键作用
大模型训练是数据密集型任务,高效的数据管道和存储体系直接影响GPU利用率。专业的数据处理与存储支持服务应包括:
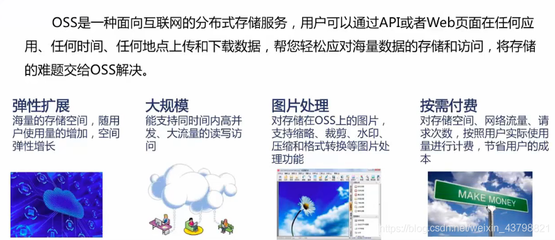
- 高速并行文件系统:采用Lustre、GPFS或Ceph等分布式文件系统,提供高吞吐、低延迟的存储访问,避免GPU因等待数据而空转。
- 数据预处理流水线:使用CPU集群或GPU加速的数据处理框架(如RAPIDS)完成数据清洗、分词、增强等操作,减轻训练主机的负载。
- 缓存与分层存储:利用NVMe SSD作为缓存层,结合大容量HDD或对象存储,实现成本与性能的平衡。
- 数据版本管理与安全:建立数据 lineage 追踪与备份机制,确保训练数据的可复现性和安全性。
对于10卡4090主机,建议配置至少50TB NVMe全闪存储用于热数据,并通过25Gb/100Gb网络接入集中式存储;H100服务器则更适合搭配200Gb InfiniBand网络和全闪并行文件系统,以充分发挥算力优势。
四、典型部署场景与建议
- 科研与教育场景:10卡RTX 4090主机+分布式存储集群,可满足多数实验室的模型微调与小规模预训练需求,性价比突出。
- 企业级大模型训练:10卡H100服务器配合高速存储与RDMA网络,适合百亿至千亿参数模型的训练,建议采用容器化调度平台(如Kubernetes)实现资源弹性分配。
- 推理服务场景:可根据并发量选择多台4090主机或H100服务器,结合模型量化与推理优化框架(如TensorRT-LLM),并通过高速缓存存储降低响应延迟。
五、
构建深度学习主机时,GPU选型只是起点,配套的数据处理与存储支持服务才是释放算力的保障。10卡RTX 4090方案以高性价比满足中小规模需求,H100服务器则为大规模训练与推理提供顶级性能。用户应结合自身业务阶段,合理规划计算、网络与存储资源,并选择专业的数据处理服务商,以构建稳定高效的AI基础设施。
如若转载,请注明出处:http://www.668a2.com/product/94.html
更新时间:2026-11-21 08:27:08